黑马点评 · 商户查询缓存 模块
声明:适合已经跟着网课过了一遍了再来看,不然感觉是看不明白的。
这份文档按黑马点评网课给的资料 PPT《02-Redis企业实战》第 27~60 页的顺序,把这一章的知识点和你项目里的代码对上。重点讲透三件事:缓存穿透、缓存雪崩、缓存击穿——它们是什么、为什么会出现、代码怎么解决。其中雪崩只讲清问题和思路,不说明代码,因为还没讲到。
这个模块涉及的文件:
service/impl/ShopServiceImpl.java     ← 主体:四种查询策略 + 更新策略
utils/CacheClient.java                ← 缓存工具类(PPT 最后一节的练习)
utils/RedisData.java                  ← 逻辑过期用的包装类
controller/ShopController.java        ← 入口
entity/Shop.java                      ← 实体,@TableName / @TableId 在这
一、PPT 学习链路 × 代码落点(总览)
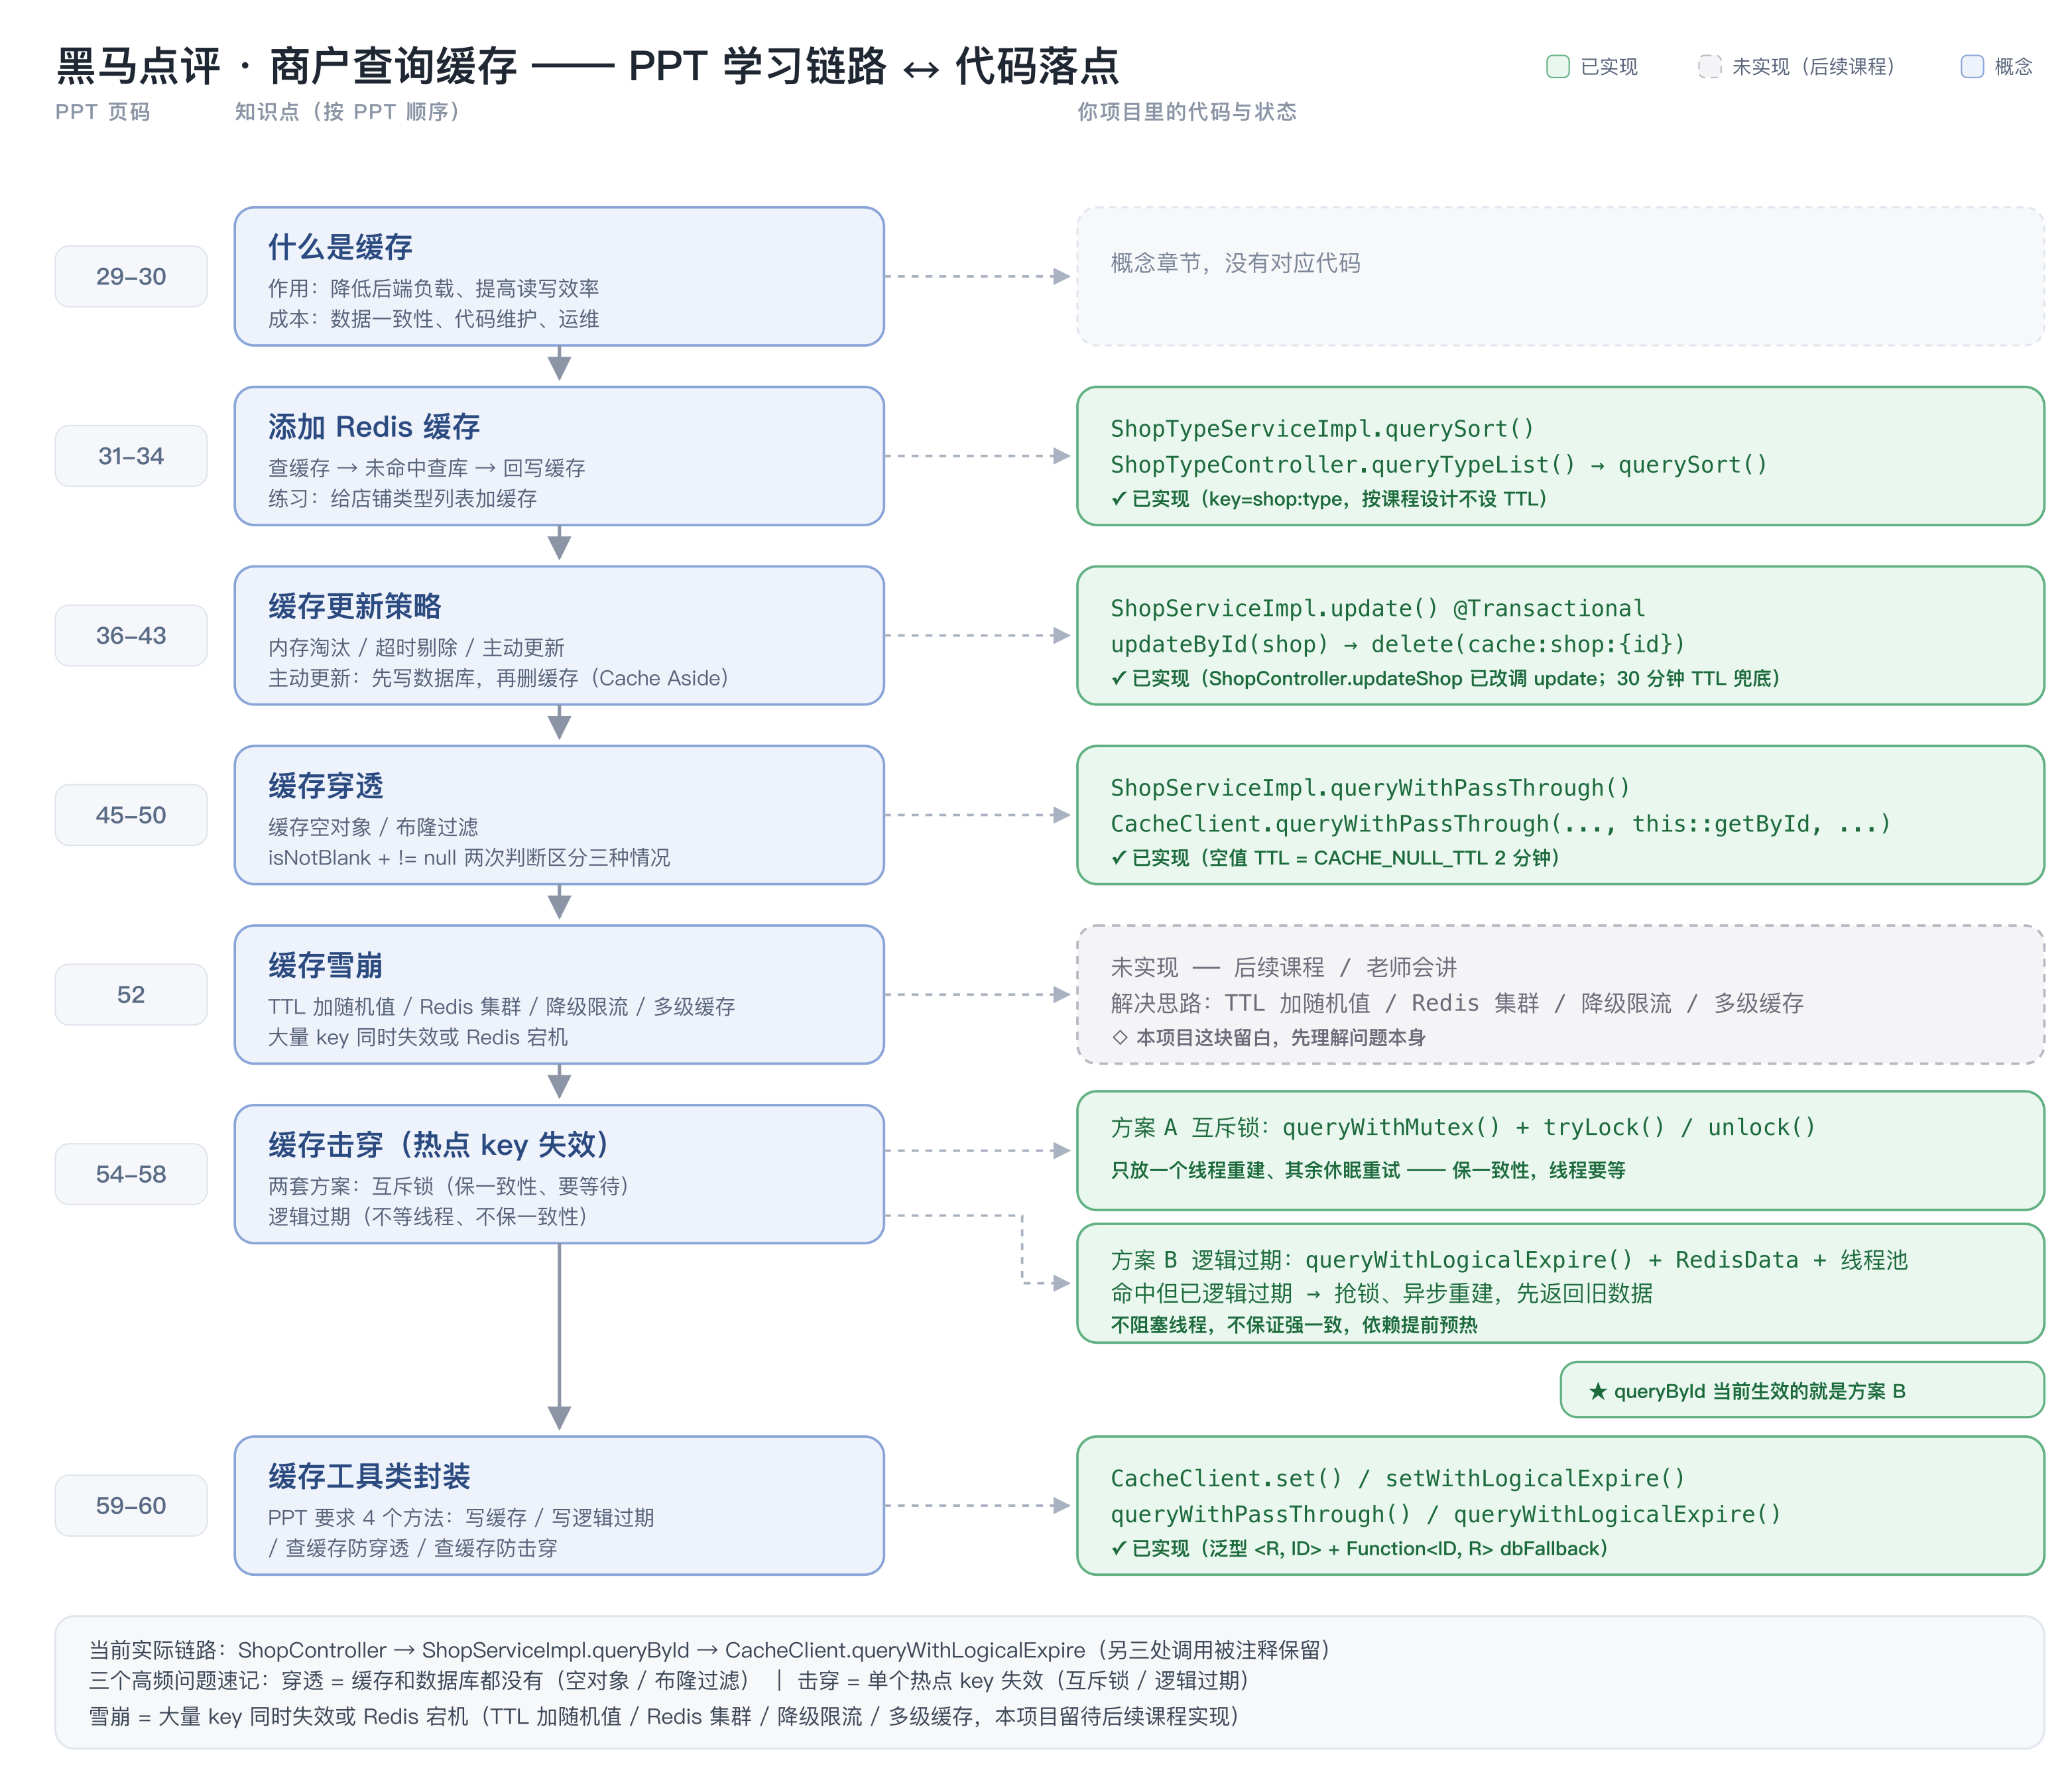
一张图三列信息叠在一起看:左列是 PPT 页码,从上往下就是你的学习顺序;中间是这一页在讲什么;右列是这块知识落在哪个方法。
颜色含义:绿色 = 已实现,灰色虚线 = 还没做(后续课程会讲),蓝色 = 纯概念、没有代码。图底部的横条是当前实际链路,以及穿透 / 击穿 / 雪崩三个问题的速记。
二、这一模块实现后典型场景是什么样子的?
2.1 读:按 id 查商铺
浏览器 GET /api/shop/1
   ↓
ShopController.queryShopById(1)
   ↓
ShopServiceImpl.queryById(1)
   ↓
CacheClient.queryWithLogicalExpire("cache:shop:", 1, Shop.class, this::getById, 30, MINUTES)
   ↓
① 查 redis: cache:shop:1
   ├─ 命中,且没到逻辑过期时间 → 直接返回(不发 SQL)
   ├─ 命中,但逻辑已过期     → 抢锁 → 开线程异步重建 → 先把旧数据返回
   └─ 完全没命中             → 返回 null → Controller 返回"店铺不存在!"
2.2 写:修改商铺
浏览器 PUT /api/shop  {id:1, name:"xxx"}
   ↓
ShopController.updateShop(shop)
   ↓
ShopServiceImpl.update(shop)      // @Transactional
   ├─ ① updateById(shop)          先写数据库
   └─ ② del cache:shop:1          再删缓存
2.3 Redis key 一览
| key | 值内容 | TTL | 由谁写入 |
|---|---|---|---|
cache:shop:{id} | Shop 的 JSON(穿透版)或 RedisData 的 JSON(逻辑过期版) | 30 分钟 / 逻辑过期版不设物理 TTL | CacheClient.set / setWithLogicalExpire |
cache:shop:{id}(空值) | 空字符串 "" | 2 分钟 | 穿透版写入的空对象 |
lock:shop:{id} | "1" | 10 秒 | tryLock |
shop:type | 店铺类型列表的 JSON | 不设(常驻) | ShopTypeServiceImpl |
三、缓存模型与第一次加缓存(PPT 29-34)
3.1 为什么要加缓存
缓存的收益和代价是绑在一起的:
| 内容 | |
|---|---|
| 作用 | 降低后端负载;提高读写效率、降低响应时间 |
| 成本 | 数据一致性成本、代码维护成本、运维成本 |
| 进一步说明: |
- 降低后端负载:后端数据库 MySQL 压力大,大量相同查询请求打到数据库,CPU、IO 压力高。缓存把热点数据放在 Redis 内存;大量请求直接读取 Redis,少访问 MySQL,减轻数据库 CPU、磁盘 IO 压力,保护数据库。
- 提高读写效率,降低响应时间:Redis 是内存数据库,内存读写速度远快于磁盘 MySQL。请求不用走磁盘 IO,接口返回更快,前端等待时间变短,用户体验更好。
- 数据一致性成本:MySQL 是主库,Redis 是缓存副本。MySQL 修改数据后,Redis 缓存如果没有及时更新 / 删除,Redis 和 MySQL 的数据不一样,就是缓存不一致。
- 业务代码变复杂,以黑马点评缓存代码举例: 要编写缓存查询逻辑:先查 Redis,缓存命中直接返回;未命中查询数据库,写入 Redis。还要处理缓存穿透、缓存击穿、缓存雪崩三种异常问题
- 运维成本: 缓存 Redis 是一套独立服务,需要部署 Redis 服务,占用服务器内存资源…
商铺详情和店铺类型是典型的”读多写少”,所以黑马点评拿它们开刀加缓存。
3.2 加缓存的六步流程
提交商铺 id
   ↓
① 从 Redis 查缓存 ──命中──→ 返回商铺信息
   ↓ 未命中
② 根据 id 查数据库
   ↓
③ 数据库存在吗?──不存在──→ 返回 404
   ↓ 存在
④ 把商铺数据写入 Redis(设 TTL)
   ↓
⑤ 返回商铺信息
3.3 代码:店铺类型列表的缓存
ShopTypeServiceImpl.querySort 就是上面这个流程:
@Override
public Result querySort() {
    String key = RedisConstants.SHOP_TYPE_KEY;// "shop:type"
    // ① 先查缓存
    String shopTypeJson = stringRedisTemplate.opsForValue().get(key);
    if (StrUtil.isNotBlank(shopTypeJson)) {
        // ② 命中直接返回
        return Result.ok(JSONUtil.toList(shopTypeJson, ShopType.class));
    }
    // ③ 未命中,查数据库
    List<ShopType> shopTypes = query().orderByAsc("sort").list();
    if (shopTypes == null || shopTypes.isEmpty()) {
        return Result.fail("没有分类数据");
    }
    // ④ 写回缓存
    stringRedisTemplate.opsForValue().set(key, JSONUtil.toJsonStr(shopTypes));
    // ⑤ 返回
    return Result.ok(shopTypes);
}
两个注意点:
为什么这里不设 TTL? 黑马点评把缓存按一致性要求分了两类:低一致性需求(店铺类型这种几乎不变的数据)可以直接依赖 Redis 的内存淘汰机制;高一致性需求(店铺详情)才需要主动更新 + 超时剔除兜底。店铺类型属于前者,所以让它常驻。
缓存入口必须在 Controller 里接通。 ShopTypeController.queryTypeList() 里要调 typeService.querySort() 才会走缓存;如果直接写 typeService.query().orderByAsc("sort").list(),缓存逻辑等于不存在,每次请求都打数据库(是使用 mybatis-plus 查数据库,具体可以看上一篇贴子)。
四、缓存更新策略
4.1 三种策略
| 策略 | 说明 | 一致性 | 维护成本 |
|---|---|---|---|
| 内存淘汰 | 不用自己维护,内存不足时 Redis 自动淘汰 | 差 | 无 |
| 超时剔除 | 给缓存加 TTL,到期自动删除,下次查询再重建 | 一般 | 低 |
| 主动更新 | 修改数据库的同时更新缓存 | 好 | 高 |
店铺详情的做法是:主动更新为主,超时剔除兜底(万一主动更新那一步失败,TTL 到期后还能自我修复)。
4.2 主动更新的三个关键问题
问题一:删缓存还是更新缓存?
删缓存。如果每次写库都顺手更新缓存,会遇到”写了很多次但根本没人读”的无效写;删掉缓存,等下次真正被读到的时候再重建,更省资源。
问题二:怎么保证缓存和数据库操作的原子性?
单体系统把两个操作放进同一个事务;分布式系统要上 TCC 之类的分布式事务方案比较麻烦了。当前项目是单体,所以加 @Transactional 就够。
问题三:先操作数据库还是先操作缓存?
先操作数据库,再删缓存。反过来的话有这样一个窗口:
线程1:删缓存 ─────────────→ 改数据库(v=20)
线程2:      查缓存未命中 → 查数据库拿到 v=10 → 写缓存 v=10
结果:数据库是 20,缓存是 10,而且这个脏数据会一直留着
而”先改库再删缓存”最坏情况只是某个请求短暂读到旧值,下一次查询就会修正,影响小得多。这就是 Cache Aside Pattern。
4.3 代码:主动更新
@Override
@Transactional
public Result update(Shop shop) {
    Long id = shop.getId();
    if (id == null) {
        return Result.fail("店铺id不能为空");
    }
    // 1. 先更新数据库
    updateById(shop);
    // 2. 再删除缓存
    stringRedisTemplate.delete(RedisConstants.CACHE_SHOP_KEY + id);
    return Result.ok();
}
Controller 侧已经从 shopService.updateById(shop) 换成了 shopService.update(shop),这样”改库 + 删缓存”才是一个整体。
兜底的 TTL 写在查询侧:set(key, json, RedisConstants.CACHE_SHOP_TTL, TimeUnit.MINUTES),也就是 30 分钟。
五、缓存穿透
5.1 什么是穿透
客户端请求的数据在缓存和数据库里都不存在。缓存永远建不起来,每个这样的请求都会打到数据库。如果有人拿一堆不存在的 id 反复请求,数据库压力会非常大。
5.2 两种解决方案
| 方案 | 原理 | 优点 | 缺点 |
|---|---|---|---|
| 缓存空对象 | 数据库查不到时,往 Redis 写一个空值(带短 TTL) | 实现简单、维护方便 | 额外内存消耗;可能短期不一致 |
| 布隆过滤 | 请求先过布隆过滤器,判定”不存在”的直接拒绝 | 内存占用小,没有多余 key | 实现复杂,存在误判;只能判断”一定不存在 / 可能存在” |
布隆过滤器为什么会有误判?它用一个位数组加多个哈希函数记录元素,多个元素可能落在相同的位上。所以它说”不存在”一定准确,说”存在”则可能是别的元素留下的痕迹。
黑马点评项目用的是缓存空对象。
5.3 代码:两次判断是整节的核心
public Shop queryWithPassThrough(Long id) {
    String key = RedisConstants.CACHE_SHOP_KEY + id;
    // 1. 从 Redis 查缓存
    String shopJson = stringRedisTemplate.opsForValue().get(key);
    // 2. 判断是否命中真实数据
    if (StrUtil.isNotBlank(shopJson)) {
        return JSONUtil.toBean(shopJson, Shop.class);
    }
    // 3. 判断命中的是不是空值缓存
    if (shopJson != null) {
        return null; // 是空值 → 直接返回失败,不打数据库
    }
    // 4. 真的没缓存,查数据库
    Shop shop = getById(id);
    // 5. 数据库也没有 → 写空值缓存,防穿透
    if (shop == null) {
        stringRedisTemplate.opsForValue().set(key, "", RedisConstants.CACHE_NULL_TTL, TimeUnit.MINUTES);
        return null;
    }
    // 6. 数据库有 → 写缓存(带 TTL,作为一致性兜底)
    stringRedisTemplate.opsForValue().set(key, JSONUtil.toJsonStr(shop),
            RedisConstants.CACHE_SHOP_TTL, TimeUnit.MINUTES);
    return shop;
}
为什么要判断两次?因为 StrUtil.isNotBlank() 对 null、""、" " 都返回 false,它区分不了”缓存里存的是空值”和”缓存里压根没有这个 key”。看这张表就清楚了:
| Redis 里的情况 | isNotBlank | != null | 代码走向 | 要不要查库 |
|---|---|---|---|---|
{"name":"103茶餐厅",...} | true | — | 第 2 步返回 Shop 对象 | 不查 |
""(之前存进去的空值) | false | true | 第 3 步返回 null | 不查(这就是防穿透) |
| key 不存在 | false | false | 继续往下第 4 步 | 查 |
所以第 3 步那个 return null 才是防穿透真正起作用的地方。
空值的 TTL 为什么只有 2 分钟? 因为空值只是一层保护,不是事实。如果商铺后来上架了,最多等 2 分钟就能被看到;TTL 太长会导致”明明有数据却一直返回不存在”。
后续的实现方式: CacheClient.queryWithPassThrough 是同一套逻辑的泛型版,把”怎么查数据库”通过 dbFallback 参数传进来,这样任何实体都能复用。
六、缓存雪崩(PPT 52)
6.1 什么是雪崩
同一时段大量缓存 key 同时失效,或者 Redis 服务直接宕机,导致大量请求一起落到数据库。
和击穿的区别在”范围”:击穿是一个热点 key 失效,雪崩是一大批 key 同时失效。比如零点批量预热了 10 万个商品缓存、TTL 都设 30 分钟,那 30 分钟后它们会在同一秒集体消失。
6.2 四个解决方向
| 方案 | 思路 |
|---|---|
| 给不同 Key 的 TTL 加随机值 | 让失效时间打散,避免同一时刻集体到期(最简单也最常用) |
| 利用 Redis 集群 | 提高服务可用性,避免单机宕机导致全量缓存不可用 |
| 给缓存业务添加降级限流 | 缓存不可用时快速失败或走兜底逻辑,保住数据库 |
| 给业务添加多级缓存 | 比如 JVM 进程内缓存 + Redis,Redis 出问题时还有本地缓存顶一下 |
这一块课程后面会讲,本文只把问题和思路讲清楚,不说明代码。 真要落地,最小改动是在写缓存的地方把 TTL 从固定值改成”固定值 + 随机偏移”。
七、缓存击穿(PPT 54-58)
这一节是整个模块的重点。
7.1 什么是击穿,和另外两个问题的区别
击穿也叫热点 Key 问题:一个被高并发访问、且缓存重建比较耗时的 key 突然失效了,无数请求会在瞬间同时去查数据库、同时重建缓存。
三个问题放在一起对比,就不会再混了:
| 缓存穿透 | 缓存击穿 | 缓存雪崩 | |
|---|---|---|---|
| 数据库里有这条数据吗 | 没有 | 有 | 有 |
| 出问题的 key 范围 | 单个(可以是很多个不同的不存在 id) | 单个热点 key | 大量 key |
| 触发原因 | 恶意或错误的请求 | 热点 key 到期 | 批量 key 同时到期 / Redis 宕机 |
| 缓存的表现 | 永远不命中 | 突然不命中 | 大面积不命中 |
| 解决方案 | 空对象、布隆过滤 | 互斥锁、逻辑过期 | TTL 随机值、集群、降级限流、多级缓存 |
7.2 两种解决方案怎么选
| 方案 | 优点 | 缺点 |
|---|---|---|
| 互斥锁 | 没有额外内存消耗、能保证一致性、实现简单 | 线程要等待,性能受影响;有死锁风险 |
| 逻辑过期 | 线程不用等待,性能好 | 不保证一致性(会返回旧数据);有额外内存消耗;实现复杂 |
一句话:要强一致用互斥锁,要高可用用逻辑过期。
7.3 方案 A:互斥锁
思路:缓存未命中时,先抢一把锁,抢到的线程去查库重建缓存,没抢到的线程睡一会儿再重试。这样同一时刻只有一个线程在建缓存,数据库不会被瞬间打穿。
查缓存 → 命中 → 返回
      → 未命中:
          抢锁 lock:shop:{id}
            抢到 → 查库 → 写缓存 → 释放锁 → 返回
            没抢到 → sleep 50ms → 递归重试
代码:
public Shop queryWithMutex(Long id) {
    String key = RedisConstants.CACHE_SHOP_KEY + id;
    // 1. 查缓存
    String shopJson = stringRedisTemplate.opsForValue().get(key);
    if (StrUtil.isNotBlank(shopJson)) {
        return JSONUtil.toBean(shopJson, Shop.class);
    }
    if (shopJson != null) {                 // 命中空值缓存
        return null;
    }
    // 2. 缓存重建
    String lockKey = RedisConstants.LOCK_SHOP_KEY + id;
    Shop shop = null;
    boolean isLock = false;
    try {
        // 2.1 抢锁
        isLock = tryLock(lockKey);
        if (!isLock) {
            // 2.2 没抢到,休眠一会儿再重试
            Thread.sleep(50);
            return queryWithMutex(id);
        }
        // 2.3 抢到了,查数据库
        shop = getById(id);
        if (shop == null) {
            // 数据库也没有 → 写空值缓存,顺便把这层也防了
            stringRedisTemplate.opsForValue()
                    .set(key, "", RedisConstants.CACHE_NULL_TTL, TimeUnit.MINUTES);
            return null;
        }
        // 2.4 写回缓存
        stringRedisTemplate.opsForValue()
                .set(key, JSONUtil.toJsonStr(shop), RedisConstants.CACHE_SHOP_TTL, TimeUnit.MINUTES);
        return shop;
    } catch (InterruptedException e) {
        throw new RuntimeException(e);
    } finally {
        if (isLock) {                       // 3. 只释放自己抢到的锁
            unlock(lockKey);
        }
    }
}
锁的实现就是 Redis 的 SET key value NX EX ttl:
private boolean tryLock(String key) {
    Boolean flag = stringRedisTemplate.opsForValue()
            .setIfAbsent(key, "1", RedisConstants.LOCK_SHOP_TTL, TimeUnit.SECONDS);  // 10 秒
    return BooleanUtil.isTrue(flag);
}

private void unlock(String key) {
    stringRedisTemplate.delete(key);
}
这段代码里有四个值得记住的细节:
① 为什么 setIfAbsent 能当锁? 它对应 SET NX,只有 key 不存在时才设置成功。谁设置成功谁就拿到了锁,天然互斥。
② 为什么锁一定要有 TTL,而且单位要用秒? 如果拿到锁的线程在重建过程中挂掉(宕机、异常),锁没有 TTL 就会永久残留,所有请求都会卡在”抢不到锁 → 重试”上。TTL 是这把锁的保命机制。重建只需要几十毫秒,课程里给 10 秒足够,配 TimeUnit.SECONDS。别写成分钟——那会让锁在出问题时残留很久。
③ 为什么释放锁要写在 finally,而且判断 isLock? 重建过程有好几个出口(成功、数据库查不到、抛异常),只要拿到过锁,每条出口都必须把锁还回去,否则就是死锁。而”没抢到锁”的那条分支不能去删锁,那会把别的线程的锁删掉,所以用 isLock 兜一下。
④ 没抢到锁为什么先 sleep 再递归? 直接忙等会白白占用 CPU;睡 50 毫秒再重试,留给持锁线程重建的时间,同时又不会让请求等太久。
7.4 方案 B:逻辑过期
思路完全不同:缓存不设物理 TTL,永远不会真的消失,而是在 value 里额外存一个”逻辑过期时间”字段。读到数据后发现逻辑上过期了,也不删缓存、不阻塞请求,而是直接返回这份旧数据,同时抢锁、开一个独立线程去后台重建。
为什么这样能防击穿?因为热点 key 永远不会”消失”,所有请求都能在缓存里拿到东西(哪怕旧一点),数据库的压力被彻底挡在门外。
数据结构:
@Data
public class RedisData {
    private LocalDateTime expireTime;   // 逻辑过期时间
    private Object data;                // 真实数据
}
存进去的 JSON 长这样:
{"data":{"id":1,"name":"103茶餐厅",...},"expireTime":"2026-09-25T12:30:00"}逻辑过期方案有个前提:缓存必须提前预热。 因为它没有物理 TTL、也没有”查不到就查库”的兜底(未命中直接返回 null),所以要提前把热点数据刷进 Redis。课程里是用一个测试方法完成的:
@SpringBootTest
class HmDianPingApplicationTests {

    @Resource
    private ShopServiceImpl shopService;

    @Test
    void testSaveShop() {
        // 预热:把数据库里的商铺按逻辑过期格式写入 Redis,逻辑有效期 10 秒
        shopService.saveShop2Redis(1L, 10L);
    }
}
预热方法就是”查库 → 套一层 RedisData → 写 Redis”,注意它不设置物理 TTL:
public void saveShop2Redis(Long id, Long expireSeconds) {
    // 1. 查数据库
    Shop shop = getById(id);
    // 2. 封装逻辑过期时间
    RedisData redisData = new RedisData();
    redisData.setData(shop);
    redisData.setExpireTime(LocalDateTime.now().plusSeconds(expireSeconds));
    // 3. 写入 Redis(不设物理 TTL)
    stringRedisTemplate.opsForValue()
            .set(RedisConstants.CACHE_SHOP_KEY + id, JSONUtil.toJsonStr(redisData));
}
查询逻辑(这是 CacheClient 里的泛型版,和 ShopServiceImpl 里那份是同一套):
private static final ExecutorService CACHE_REBUILD_EXECUTOR = Executors.newFixedThreadPool(10);

public <R, ID> R queryWithLogicalExpire(String keyPrefix, ID id, Class<R> type,Function<ID, R> dbFallback, Long time, TimeUnit unit) {
    String key = keyPrefix + id;
    // 1. 查缓存
    String json = stringRedisTemplate.opsForValue().get(key);
    if (StrUtil.isBlank(json)) {
        return null;                 // 未命中直接返回(逻辑过期依赖预热)
    }
    // 2. 反序列化:RedisData → 真实对象
    RedisData redisData = JSONUtil.toBean(json, RedisData.class);
    R r = JSONUtil.toBean((JSONObject) redisData.getData(), type);
    LocalDateTime expireTime = redisData.getExpireTime();

    // 3. 逻辑没过期,直接返回
    if (expireTime.isAfter(LocalDateTime.now())) {
        return r;
    }

    // 4. 逻辑已过期:抢锁 + 异步重建
    String lockKey = RedisConstants.LOCK_SHOP_KEY + id;
    boolean isLock = tryLock(lockKey);
    if (isLock) {
        // 4.1 抢到锁,丢给线程池去重建,当前线程不等它
        CACHE_REBUILD_EXECUTOR.submit(() -> {
            try {
                R fresh = dbFallback.apply(id);
                if (fresh == null) {
                    stringRedisTemplate.delete(key);
                    return;
                }
                setWithLogicalExpire(key, fresh, time, unit);   // 重置逻辑过期时间
            } catch (Exception e) {
                throw new RuntimeException(e);
            } finally {
                unlock(lockKey);                // 重建完(或失败)都要放锁
            }
        });
    }
    // 4.2 不管有没有抢到锁,都先把旧数据返回给用户
    return r;
}
几个关键点:
① 为什么用线程池而不是 new Thread? 热点 key 每次过期都会创建一个重建任务,高并发下用 new Thread 会不停创建销毁线程。固定 10 个线程的池子既控制了资源,也避免重建任务把 Tomcat 的请求线程占满。
② 为什么抢到锁的线程也立刻 return r? 这是逻辑过期和互斥锁最大的区别。互斥锁方案里,抢到锁的线程必须等数据库查完、缓存写完才能返回;逻辑过期方案里,重建交给别的线程去做,当前线程马上把旧数据返回,用户感知不到等待。
③ 重建失败或者数据库里数据被删了怎么办? 所以重建任务里要有 try / finally:异常也要放锁,否则锁残留;数据库查不到就删掉缓存,避免反复拿一份空数据。
④ 一次典型的时间线:
t=0    预热写入,expireTime = t+10
t=5    请求 → 逻辑未过期 → 直接返回
t=12   请求 → 逻辑已过期 → 抢锁成功 → 返回旧值,线程池开始重建
t=12   请求 → 逻辑已过期 → 抢锁失败 → 直接返回旧值(不阻塞)
t=12.x 重建完成 → 覆盖缓存,expireTime 重置为 t+10
t=13   请求 → 逻辑未过期 → 返回新值
八、缓存工具类封装
这一节是整章的收口。前面几个知识点各写了一遍缓存逻辑:查缓存、判空值、查数据库、写缓存、抢锁、异步重建。如果再来一个 Voucher、Blog 要缓存,这些代码还得抄一遍。工具类要解决的就是这件事——把”缓存怎么读写 + 三种防护策略”抽出来,业务侧只提供”数据怎么查”。
PPT 要求四个方法,对应 CacheClient 的四个 public 方法:
| PPT 要求 | CacheClient 里的方法 | 属于 |
|---|---|---|
| 方法 1:对象序列化成 JSON 存 string,可设 TTL | set(key, value, time, unit) | 写 |
| 方法 2:对象序列化成 JSON 存 string,可设逻辑过期时间 | setWithLogicalExpire(key, value, time, unit) | 写 |
| 方法 3:按 key 查缓存并反序列化,用空值解决穿透 | queryWithPassThrough(keyPrefix, id, type, dbFallback, time, unit) | 读 |
| 方法 4:按 key 查缓存并反序列化,用逻辑过期解决击穿 | queryWithLogicalExpire(keyPrefix, id, type, dbFallback, time, unit) | 读 |
8.1 类的骨架
@Slf4j
@Component
public class CacheClient {

    private final StringRedisTemplate stringRedisTemplate;

    // 构造器注入:依赖不可变,便于测试时手动 new
    public CacheClient(StringRedisTemplate stringRedisTemplate) {
        this.stringRedisTemplate = stringRedisTemplate;
    }

    // 重建缓存用的线程池,全类共享
    private static final ExecutorService CACHE_REBUILD_EXECUTOR = Executors.newFixedThreadPool(10);

    public void set(String key, Object value, Long time, TimeUnit unit) { ... }
    public void setWithLogicalExpire(String key, Object value, Long time, TimeUnit unit) { ... }
    public <R, ID> R queryWithPassThrough(String keyPrefix, ID id, Class<R> type,Function<ID, R> dbFallback, Long time, TimeUnit unit) { ... }
    public <R, ID> R queryWithLogicalExpire(String keyPrefix, ID id, Class<R> type,Function<ID, R> dbFallback, Long time, TimeUnit unit) { ... }

    private boolean tryLock(String key) { ... }
    private void unlock(String key) { ... }
}
有三个设计细节值得说:
① 为什么用构造器注入而不是 @Resource? StringRedisTemplate 是这个类唯一且必须的依赖,用构造器注入可以让字段是 final,依赖一旦创建就不会变;同时单元测试里可以直接 new CacheClient(redisTemplate),不用起 Spring 容器。@Resource 字段注入做不到这两点。
② 为什么线程池是 static final? 它不属于某一次调用,而是整个工具类共享的资源。CacheClient 本身是单例 Bean(@Component 默认就是单例),所以写成实例字段效果也一样,static 只是把”全局唯一”这件事表达得更明确。
③ 为什么 tryLock / unlock 是 private? 它们只是逻辑过期重建的内部配套,不对外暴露。要留意的是,这两个方法目前是”最简版锁”——只删 key、不校验持有者,后面分布式锁那一章会讲它的三个问题(锁误删、不可重入、拿不到锁无法等待),到时这类能力应该抽成独立的 LockClient,而不是继续塞在缓存工具类里。
8.2 两个”写”方法
// 方法 1:写缓存,带物理 TTL —— 配合 queryWithPassThrough 使用
public void set(String key, Object value, Long time, TimeUnit unit) {
    stringRedisTemplate.opsForValue().set(key, JSONUtil.toJsonStr(value), time, unit);
}

// 方法 2:写缓存,带逻辑过期时间 —— 配合 queryWithLogicalExpire 使用
public void setWithLogicalExpire(String key, Object value, Long time, TimeUnit unit) {
    RedisData redisData = new RedisData();
    redisData.setData(value);
    redisData.setExpireTime(LocalDateTime.now().plusSeconds(unit.toSeconds(time)));
    stringRedisTemplate.opsForValue().set(key, JSONUtil.toJsonStr(redisData));   // 注意:没有物理 TTL
}
两个方法存进 Redis 的东西完全不一样,这是理解后面”读方法必须配套”的关键:
set 存的是裸对象 JSON,而且真的会过期:
key   = cache:shop:1
value = {"id":1,"name":"103茶餐厅","typeId":1,...}
TTL   = 1800 秒
setWithLogicalExpire 存的是一层包装,而且物理上永不过期:
key   = cache:shop:1
value = {"data":{"id":1,"name":"103茶餐厅",...},"expireTime":"2026-09-25T13:40:00"}
TTL   = -1(不设置物理 TTL)
setWithLogicalExpire 里那行 unit.toSeconds(time) 是把”数值 + 单位”统一换算成秒,因为 LocalDateTime.plusSeconds 只认秒。这样调用方传 30, TimeUnit.MINUTES 或 1800, TimeUnit.SECONDS 结果一致。
为什么逻辑过期版坚决不设物理 TTL? 因为它抗击穿的原理就是”热点 key 永远不消失”。如果顺手加一个 30 分钟的物理 TTL,key 到点就被 Redis 删了,所有请求会同时发现”缓存没了”,又退化成击穿——前面那套异步重建的机制等于白写。逻辑过期只用一个字段表达”数据该更新了”,数据的物理存在由它自己保证。
8.3 方法 3:queryWithPassThrough(防穿透)
public <R, ID> R queryWithPassThrough(String keyPrefix, ID id, Class<R> type,unction<ID, R> dbFallback, Long time, TimeUnit unit) {
    String key = keyPrefix + id;
    // ① 查缓存
    String json = stringRedisTemplate.opsForValue().get(key);
    // ② 命中真实数据 → 反序列化返回
    if (StrUtil.isNotBlank(json)) {
        return JSONUtil.toBean(json, type);
    }
    // ③ 命中的是空值 → 直接返回 null,不打数据库(防穿透的核心)
    if (json != null) {
        return null;
    }
    // ④ 真的没缓存 → 调用方传进来的查询逻辑
    R r = dbFallback.apply(id);
    // ⑤ 数据库也没有 → 写空值缓存,TTL 用固定常量
    if (r == null) {
        stringRedisTemplate.opsForValue()
                .set(key, "", RedisConstants.CACHE_NULL_TTL, TimeUnit.MINUTES);
        return null;
    }
    // ⑥ 数据库有 → 写缓存(复用方法 1)
    this.set(key, r, time, unit);
    return r;
}
和行为上的五个分支:
| Redis / 数据库的情况 | 走向 | 是否查库 |
|---|---|---|
| 命中真实数据 | ② 反序列化返回 | 不查 |
| 命中空字符串 | ③ 返回 null | 不查 |
| key 不存在 → 数据库有 | ④⑥ 查库、写缓存、返回 | 查 |
| key 不存在 → 数据库没有 | ④⑤ 查库、写空值、返回 null | 查(只有第一次) |
| 命中真实数据但已物理过期 | 同”key 不存在” | 查 |
两个容易被忽略的点:
空值的 TTL 用的是常量 CACHE_NULL_TTL,不是参数 time。 这是有意的:业务数据的 TTL(30 分钟)和空值保护的 TTL(2 分钟)语义完全不同,前者越长越省数据库,后者越长越容易”数据明明有了却看不到”,所以不能共用一个参数。代价是空值 TTL 目前写死在工具类里,如果将来不同业务需要不同的空值 TTL,就得再加一个参数。
工具类里没有互斥锁版。 互斥锁方案带”抢不到锁就休眠重试”甚至递归的逻辑,把它泛型化以后参数和分支会变得很绕,而它的收益又不如逻辑过期明显,所以课程只把穿透和逻辑过期两个读取策略收进了工具类。互斥锁版继续留在 ShopServiceImpl 里作为方法存在。
8.4 方法 4:queryWithLogicalExpire(防击穿)
public <R, ID> R queryWithLogicalExpire(String keyPrefix, ID id, Class<R> type,Function<ID, R> dbFallback, Long time, TimeUnit unit) {
    String key = keyPrefix + id;
    // ① 查缓存
    String json = stringRedisTemplate.opsForValue().get(key);
    if (StrUtil.isBlank(json)) {
        // ② 未命中直接返回 null(逻辑过期依赖预热,这里不做查库兜底)
        return null;
    }
    // ③ 命中:先把包装层拆开
    RedisData redisData = JSONUtil.toBean(json, RedisData.class);
    JSONObject data = (JSONObject) redisData.getData();
    R r = JSONUtil.toBean(data, type);
    LocalDateTime expireTime = redisData.getExpireTime();

    // ④ 逻辑没过期 → 直接返回
    if (expireTime.isAfter(LocalDateTime.now())) {
        return r;
    }

    // ⑤ 逻辑已过期 → 抢锁,抢到就异步重建
    String lockKey = RedisConstants.LOCK_SHOP_KEY + id;
    boolean isLock = tryLock(lockKey);
    if (isLock) {
        CACHE_REBUILD_EXECUTOR.submit(() -> {
            try {
                R fresh = dbFallback.apply(id);
                if (fresh == null) {
                    stringRedisTemplate.delete(key);
                    return;
                }
                setWithLogicalExpire(key, fresh, time, unit);   // 重置逻辑过期时间
            } catch (Exception e) {
                throw new RuntimeException(e);
            } finally {
                unlock(lockKey);                 // 重建完(或失败)都要放锁
            }
        });
    }
    // ⑥ 不管抢没抢到锁,都先把旧数据返回
    return r;
}
8.5 泛型和回调:这个类为什么能通用
以方法 3 的签名为例:
public <R, ID> R queryWithPassThrough(String keyPrefix, ID id, Class<R> type,unction<ID, R> dbFallback, Long time, TimeUnit unit)| 参数 | 作用 |
|---|---|
<R, ID> | 泛型:R 是业务对象类型,ID 是主键类型,工具类不绑死任何实体 |
keyPrefix | key 前缀,比如 "cache:shop:",和 id 拼成完整 key |
id | 业务 id |
type | 反序列化目标类型,JSONUtil.toBean(json, type) 用得到 |
dbFallback | 缓存没命中时怎么查数据库,由调用方决定 |
time / unit | TTL 的数值和单位 |
调用一次,看编译器怎么把泛型推出来:
Shop shop = cacheClient.queryWithPassThrough(
        RedisConstants.CACHE_SHOP_KEY,          // keyPrefix
        id,                                 //id 是 Long  →  ID = Long
        Shop.class,                         // Class<Shop>  →  R = Shop
        this::getById,                     // 必须是 Function<Long, Shop>
        RedisConstants.CACHE_SHOP_TTL,
        TimeUnit.MINUTES);
Shop.class 把 R 定成 Shop,id 把 ID 定成 Long,于是 dbFallback 的类型被确定为 Function<Long, Shop> ——“吃一个 Long,吐一个 Shop”。this::getById 正好符合:MyBatis-Plus 的 IService 提供 getById(Serializable id),返回实体本身,Long 是 Serializable 的子类,方法引用能直接匹配。
这就是把行为参数化:工具类只负责”缓存怎么读写”,它不知道也不想知道数据从哪来。换成别的方案都别扭——
| 备选设计 | 问题 |
|---|---|
工具类里注入 ShopMapper | 工具类就绑死在 Shop 上,别的实体用不了 |
| 传一段 SQL 字符串 | 要自己管参数绑定,等于把 MyBatis 的活重做一遍 |
传 Class<? extends BaseMapper> | 只能应付单表主键查询,联查、多条件都做不了 |
正因为查询动作是参数,这个工具类可以给任何实体复用。比如给优惠券也加一份缓存(示例,不是项目现有代码):
// 只需换掉 key 前缀、返回类型和查询方法,其余逻辑一行都不用改
public Voucher queryVoucherById(Long id) {
    return cacheClient.queryWithPassThrough(
            RedisConstants.CACHE_VOUCHER_KEY, id, Voucher.class,
            this::getById, RedisConstants.CACHE_VOUCHER_TTL, TimeUnit.MINUTES);
}
逻辑过期那套同理,只是调用方要额外用 setWithLogicalExpire 做一次预热,因为读取端不做查库兜底。
8.6 写方法和读方法必须配套
这是实际用这个工具类时最容易踩的地方。两个写方法存的数据结构不同,两个读方法也只认自己那一套:
| 写入方式 | Redis 里的 JSON | 必须配对的读方法 |
|---|---|---|
set(key, value, 30, MINUTES) | {"id":1,"name":"103茶餐厅",...} | queryWithPassThrough(...) |
setWithLogicalExpire(key, value, 30, MINUTES) | {"data":{...},"expireTime":"2026-09-25T13:40:00"} | queryWithLogicalExpire(...) |
配错了会有两种结果,而且都不太直观:
- 逻辑过期的数据用穿透版读:
JSONUtil.toBean(json, Shop.class)会把data、expireTime这两个不认识的字段忽略掉,然后返回一个字段全是 null 的”空壳 Shop”。接口不报错,但数据是空的——这种问题比报错更难查。 - 普通缓存的数据用逻辑过期版读:
redisData.getExpireTime()拿到 null,紧接着expireTime.isAfter(...)直接抛NullPointerException。
所以切换策略时,写入侧和读取侧要一起改;如果缓存里已经有旧格式的 key,先删掉再切。
8.7 手写版和工具类版的对应关系
ShopServiceImpl 里的手写方法 | 等价的工具类调用 |
|---|---|
queryWithPassThrough(id) | cacheClient.queryWithPassThrough(CACHE_SHOP_KEY, id, Shop.class, this::getById, CACHE_SHOP_TTL, MINUTES) |
queryWithMutex(id) | 工具类未封装(互斥锁带重试/递归,泛型化不划算,继续留在业务层) |
queryWithLogicalExpire(id) + saveShop2Redis(id, 20L) | cacheClient.queryWithLogicalExpire(CACHE_SHOP_KEY, id, Shop.class, this::getById, CACHE_SHOP_TTL, MINUTES),预热改用 setWithLogicalExpire(...) |
私有的 tryLock / unlock | 工具类内部同名的 private 方法 |
对比一下就能看出封装的收益:手写版里”查缓存 → 判空值 → 查库 → 判空 → 写空值/写缓存”这一串要写十几行,而且每个实体都要重写一遍;工具类版把这些固定套路收进一个方法,业务侧只剩一行调用,变的只有三个参数(key 前缀、类型、查询方法)。