黑马点评 · 好友关注模块
这一模块分三部分:关注和取关、共同关注、关注推送(Feed 流)。前两块用的是 Redis 的 Set,第三块用 ZSet,并且带出一个新问题——Feed 流不能用传统分页,需要自己设计滚动分页。
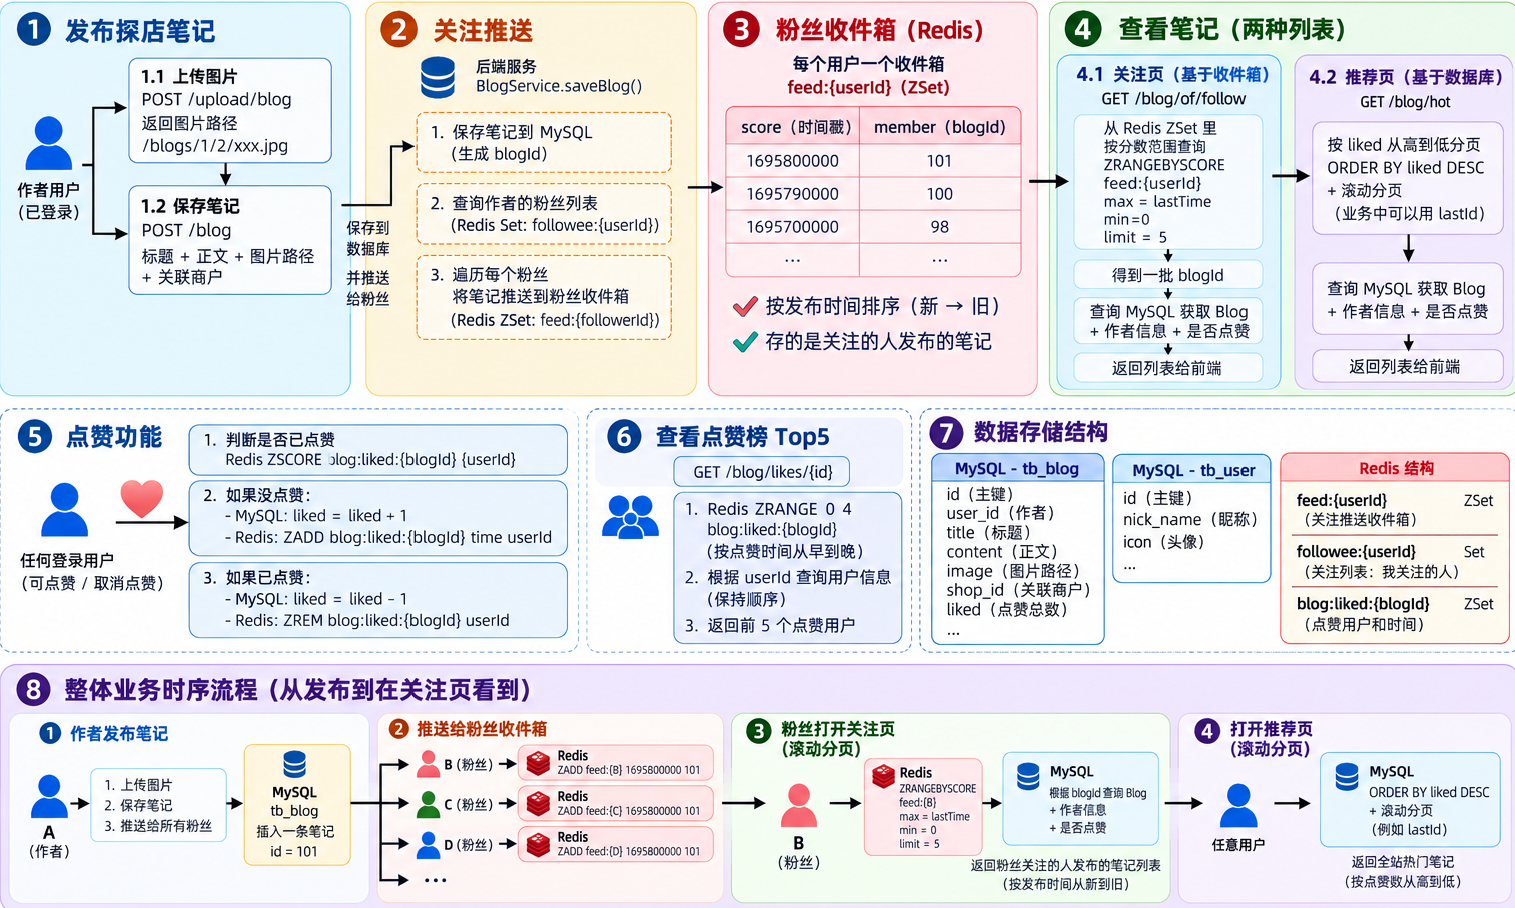
一、这一模块要解决什么问题
| 功能 | 要解决的问题 | 用到的 Redis 结构 |
|---|---|---|
| 关注和取关 | 谁能关注谁,关系存在哪,怎么判断”我关注他了吗” | Set(follows:{userId}) |
| 共同关注 | 我和他都关注了谁,怎么快速求出交集 | Set 的 SINTER |
| 关注推送 | 我关注的人发了笔记,我怎么在自己的主页看到 | ZSet(feed:{userId}) |
| 滚动分页 | Feed 流数据一直在头部新增,怎么分页才不会重复读、漏读 | ZSet 的 ZREVRANGEBYSCORE |
前两个功能的难点在”数据放哪、怎么查”,第三个功能的难点在”分页怎么设计”。滚动分页是这一章最需要理解透的地方。
二、接口清单
| 功能 | 请求方式 | 请求路径 | 请求参数 | 返回值 |
|---|---|---|---|---|
| 关注 / 取关 | PUT | /follow/{id}/{isFollow} | id:目标用户 id;isFollow:true 关注,false 取关 | 无 |
| 是否关注 | GET | /follow/or/not/{id} | id:目标用户 id | Boolean |
| 共同关注 | GET | /follow/common/{id} | id:目标用户 id | List<UserDTO> |
| 查询用户 | GET | /user/{id} | id:用户 id | UserDTO |
| 博主的笔记 | GET | /blog/of/user | current:页码,默认 1;id:博主 id | List<Blog> |
| 发布笔记(改造) | POST | /blog | Blog 对象 | 笔记 id |
| 关注推送分页 | GET | /blog/of/follow | lastId:上次返回的最小时间戳;offset:偏移量 | ScrollResult |
三个需要注意的地方:
- 关注和取关共用一个接口,用路径上的
isFollow区分,写入操作所以用PUT。 /blog/of/follow的两个参数都是”上一次请求的返回值”,第一次请求由前端传lastId = 当前时间戳、offset = 0。MvcConfig里只放行了/user/code和/user/login,本章所有接口都需要登录,UserHolder.getUser()不会为空。
三、数据模型
3.1 关注关系表 tb_follow
| 字段 | 类型 | 说明 |
|---|---|---|
id | bigint | 主键,自增 |
user_id | bigint unsigned | 用户 id,也就是”粉丝”这一方 |
follow_user_id | bigint unsigned | 关联的用户 id,也就是”被关注的人” |
create_time | timestamp | 创建时间 |
“user_id 关注了 follow_user_id”。所以查”我的粉丝”是 where follow_user_id = 我,查”我关注了谁”是 where user_id = 我,两个方向别写反。
老师专门提示了一句:把主键修改为自增长,简化开发。原因是 Follow 实体用的是 @TableId(value = "id", type = IdType.AUTO),如果表里主键不是自增,save() 插入时会因为主键没值而失败。
3.2 Redis 键的设计
本章新增了一个常量,另一个是直接拼字符串写的:
// RedisConstants
public static final String FEED_KEY = "feed:"; // 本章新增| key | 结构 | member | score | 用途 |
|---|---|---|---|---|
follows:{userId} | Set | 该用户关注的人的 id | 无 | 求共同关注 |
feed:{userId} | ZSet | 笔记 id | 笔记发布的时间戳 | 关注推送的收件箱 |
两个 key 的”归属”方向不一样,写代码时容易搞混,先记住:
follows:{A}存的是 A 关注了谁,所以 A 的收件箱才有意义。feed:{A}是 A 的收件箱,里面是别人推给 A 的笔记。
四、功能一:关注和取关
4.1 需求与设计
在探店图文详情页可以关注作者,要实现两个接口——关注/取关接口、判断是否关注的接口。
设计上有三个决定:
- 关注和取关合成一个接口。两者都是”把关系改成某个状态”,用路径参数
isFollow区分,前端传true表示关注,false表示取关,省掉一个接口。 - 数据库是唯一事实来源。
tb_follow存真实关系,isFollow判断也查数据库。 - Redis 里再存一份”我关注了谁”。这一份不是给”是否关注”用的,而是专门为了共同关注那个
SINTER交集运算。数据库求交集要JOIN两张表,Redis 一句命令就够。
4.2 follow 怎么写
按 4.1 的思路,方法骨架是:取当前用户 → 判断是关注还是取关 → 走对应分支 → 每个分支里先改数据库,成功再改 Redis。
@Override
public Result follow(Long followUserId, Boolean isFollow) {
    // 1.获取登录用户
    Long userId = UserHolder.getUser().getId();
    String key = "follows:" + userId;
    // 1.判断到底是关注还是取关
    if (isFollow) {
        // 2.关注,新增数据
        Follow follow = new Follow();
        follow.setUserId(userId);
        follow.setFollowUserId(followUserId);
        boolean isSuccess = save(follow);
        if (isSuccess) {
            // 把关注用户的id,放入redis的set集合 sadd userId followerUserId
            stringRedisTemplate.opsForSet().add(key, followUserId.toString());
        }
    } else {
        // 3.取关,删除 delete from tb_follow where user_id = ? and follow_user_id = ?
        boolean isSuccess = remove(new QueryWrapper<Follow>()
                .eq("user_id", userId).eq("follow_user_id", followUserId));
        if (isSuccess) {
            // 把关注用户的id从Redis集合中移除
            stringRedisTemplate.opsForSet().remove(key, followUserId.toString());
        }
    }
    return Result.ok();
}
逐段对应:
| 代码 | 在做什么 | 实际执行的命令 / SQL |
|---|---|---|
UserHolder.getUser().getId() | 取当前登录用户,也就是”粉丝”这一方 | 无 |
new Follow() + 两个 set + save(follow) | 插入一条关注关系 | INSERT INTO tb_follow (user_id, follow_user_id) VALUES (?, ?) |
opsForSet().add(key, ...) | 记进”我关注了谁” | SADD follows:{我} {对方id} |
remove(new QueryWrapper<>()...) | 删掉这条关注关系 | DELETE FROM tb_follow WHERE user_id = ? AND follow_user_id = ? |
opsForSet().remove(key, ...) | 从集合里删掉 | SREM follows:{我} {对方id} |
三个细节:
user_id和follow_user_id的赋值不能反。follow.setUserId(userId)里是当前登录用户(粉丝),follow.setFollowUserId(followUserId)是路径参数传进来的目标用户(被关注的人)。写反了,后面查询粉丝的逻辑会全部失效。- 取关的删除条件必须带上
user_id。只按follow_user_id删会把所有人的关注关系都删掉,一定要user_id = 当前用户 AND follow_user_id = 目标用户。 if (isSuccess)兜底。数据库没改动成功(比如重复关注导致插入失败)就不动 Redis,保持两边尽量一致,和点赞那个模块的处理方式一样。
4.3 isFollow 怎么写
@Override
public Result isFollow(Long followUserId) {
    // 1.获取登录用户
    Long userId = UserHolder.getUser().getId();
    // 2.查询是否关注 select count(*) from tb_follow where user_id = ? and follow_user_id = ?
    Integer count = query().eq("user_id", userId).eq("follow_user_id", followUserId).count();
    // 3.判断
    return Result.ok(count > 0);
}
用 count() 而不是 getOne(),因为只要知道”有没有”,不需要把整行查出来。count > 0 的结果(一个布尔值)直接塞进 Result.ok() 返回给前端,前端用它决定按钮显示”关注”还是”已关注”。
这里为什么查数据库而不查 Redis。Redis 里已经有 follows:{我} 了,SISMEMBER 也能判断。但数据库是事实来源,Redis 里的数据可能因为重启、过期、写失败而不准。判断关注状态是个单行带条件的查询,成本很低,用数据库换准确性是划算的。Redis 那份数据只在”求交集”这种能容忍误差的场景里用。
4.4 交互流程
用户在探店笔记详情页点”关注”按钮:
- 进页面时调
GET /follow/or/not/{作者id},拿到true/false,按钮显示对应的样式。 - 点按钮调
PUT /follow/{作者id}/{true或false}。 - 后端写
tb_follow,同时维护follows:{我}。
五、功能二:博主个人主页
点博主头像进入博主首页,这个页面依赖两个已有的接口。
5.1 根据 id 查询用户
@GetMapping("/{id}")
public Result queryUserById(@PathVariable("id") Long userId){
    // 查询详情
    User user = userService.getById(userId);
    if (user == null) {
        return Result.ok();
    }
    UserDTO userDTO = BeanUtil.copyProperties(user, UserDTO.class);
    // 返回
    return Result.ok(userDTO);
}
两个点:查不到用户时返回 Result.ok()(data 为 null),让前端自己去判断,而不是报错;查到之后转成 UserDTO,因为 User 里有 password 字段,直接返回会把密码带给前端。
这个接口在 UserController 里,路径是 /user/{id}。注意它和已有的 /user/info/{id} 不冲突,因为路径多了一段。
5.2 根据 id 查询博主的笔记
@GetMapping("/of/user")
public Result queryBlogByUserId(
        @RequestParam(value = "current", defaultValue = "1") Integer current,
        @RequestParam("id") Long id) {
    // 根据用户查询
    Page<Blog> page = blogService.query()
            .eq("user_id", id).page(new Page<>(current, SystemConstants.MAX_PAGE_SIZE));
    // 获取当前页数据
    List<Blog> records = page.getRecords();
    return Result.ok(records);
}
按 user_id 过滤加分页,逻辑和”我的笔记”(/blog/of/me)几乎一样,区别只是用户 id 从请求参数来而不是从 UserHolder 来。
这个方法没有补作者信息和 isLike。原因是这个页面本身就是博主的个人主页,前端已经知道作者是谁了,不用后端再查一遍;至于 isLike,虎哥在这里没补,要补的话和热门列表一样调 isBlogLiked 就行。
六、功能三:共同关注
6.1 需求
在博主个人页面展示当前用户与博主的共同好友。
| 说明 | 内容 |
|---|---|
| 请求方式 | GET |
| 请求路径 | /follow/common/{id} |
| 请求参数 | id:目标用户 id |
| 返回值 | List<UserDTO>,两人共同关注的人 |
6.2 思路:为什么用 Set 求交集
“我和他都关注的人”就是两个集合的交集。放到 Redis 里,如果两个人的关注列表各自是一个 Set,那 SINTER key1 key2 一句话就能算出来。
这正是 4.2 里每次关注都顺手维护 follows:{userId} 的原因——它不是为了”是否关注”,而是为了这里能直接做集合运算。用数据库做这件事要写 SELECT ... FROM tb_follow a JOIN tb_follow b ON a.follow_user_id = b.follow_user_id WHERE a.user_id = ? AND b.user_id = ?,Redis 一条命令就完事,而且天然去重。
6.3 代码
@Override
public Result followCommons(Long id) {
    // 1.获取当前用户
    Long userId = UserHolder.getUser().getId();
    String key = "follows:" + userId;
    // 2.求交集
    String key2 = "follows:" + id;
    Set<String> intersect = stringRedisTemplate.opsForSet().intersect(key, key2);
    if (intersect == null || intersect.isEmpty()) {
        // 无交集
        return Result.ok(Collections.emptyList());
    }
    // 3.解析id集合
    List<Long> ids = intersect.stream().map(Long::valueOf).collect(Collectors.toList());
    // 4.查询用户
    List<UserDTO> users = userService.listByIds(ids)
            .stream()
            .map(user -> BeanUtil.copyProperties(user, UserDTO.class))
            .collect(Collectors.toList());
    return Result.ok(users);
}
四步:拼两个 key → SINTER 求交集 → 把成员转成 Long → 用 listByIds 查用户并转 UserDTO。
intersect(key, key2)对应SINTER follows:{我} follows:{他},返回的是Set<String>,已经去过重。- 交集为空时返回
Result.ok(Collections.emptyList()),保证前端拿到的data是数组而不是 null。 userService.listByIds(ids)是 MyBatis-Plus 提供的方法,对应SELECT ... WHERE id IN (...)。这里不需要像点赞排行榜那样ORDER BY FIELD保序,因为共同关注只是一个列表,谁先谁后无所谓。
6.4 完整交互流程
假设 A 打开了 B 的主页:
GET /user/{B}拿到 B 的昵称头像。GET /blog/of/user?current=1&id=B拿到 B 发的笔记。GET /follow/or/not/{B}拿到”我有没有关注 B”,决定按钮样式。GET /follow/common/{B}拿到共同关注,用的是SINTER follows:{A} follows:{B}。
七、功能四:关注推送(Feed 流)
7.1 什么是 Feed 流
关注推送也叫 Feed 流(投喂),通过无限下拉刷新给用户持续提供新内容,朋友圈就是典型例子。
Feed 流产品有两种模式:
- Timeline:不筛选内容,单纯按发布时间排序,常用于好友或关注。优点是信息全面、实现简单,缺点是噪音多、获取效率低。
- 智能排序:用算法挑用户感兴趣的内容。投喂精准、用户黏性高,但算法不准会起反作用。
本章是”关注的人发的笔记”这种场景,用的是 Timeline。
7.2 Timeline 的三种实现方案
三种方案,核心区别是”写的时候推,还是读的时候拉”。
| 拉模式 | 推模式 | 推拉结合 | |
|---|---|---|---|
| 写比例 | 低 | 高 | 中 |
| 读比例 | 高 | 低 | 中 |
| 用户读取延迟 | 高 | 低 | 低 |
| 实现难度 | 复杂 | 简单 | 很复杂 |
| 使用场景 | 很少使用 | 用户量少、没有大 V | 过千万的用户量,有大 V |
- 拉模式(读扩散):每个人只写自己的发件箱。读的时候,把我关注的所有人的发件箱都读一遍,在内存里合并排序。写少读多,读的人越多压力越大,延迟也高。
- 推模式(写扩散):发笔记时,直接把笔记 id 塞进所有粉丝的收件箱。读的时候只读自己的收件箱,一步到位,延迟低。代价是写的时候要写很多份,粉丝越多写得越慢。
- 推拉结合(读写混合):普通人用推,大 V 用拉。大 V 发内容不推给所有人,粉丝读的时候再单独去拉大 V 的内容合并进来。兼顾了两者,但实现最复杂。
本章选推模式,理由就是表格最后一行——黑马点评的用户量小、没有大 V,写扩散的成本可以接受,而读的时候只查一个 key,实现起来最简单,也正好能练 ZSet 的用法。
7.3 写扩散:saveBlog 怎么写
需求:
- 修改新增探店笔记的业务,在保存 blog 到数据库的同时,推送到粉丝的收件箱。
- 收件箱要能按时间戳排序,必须用 Redis 的数据结构实现。
- 查询收件箱时要能分页。
按需求推导:收件箱要”按时间排序”又要”能分页取一段”,ZSet 用时间戳做 score 正合适;每篇笔记在收件箱里是一个 member(笔记 id),score 是发布时间。所以 saveBlog 在原来”存库”的基础上,多了”查粉丝、逐个推”两步。
原来的 saveBlog 在 Controller 里,本章把它搬进 BlogServiceImpl,因为这个方法现在要多做两件事,Controller 里塞不下:
@Override
public Result saveBlog(Blog blog) {
    // 1.获取登录用户
    UserDTO user = UserHolder.getUser();
    blog.setUserId(user.getId());
    // 2.保存探店笔记
    boolean isSuccess = save(blog);
    if(!isSuccess){
        return Result.fail("新增笔记失败!");
    }
    // 3.查询笔记作者的所有粉丝 select * from tb_follow where follow_user_id = ?
    List<Follow> follows = followService.query().eq("follow_user_id", user.getId()).list();
    // 4.推送笔记id给所有粉丝
    for (Follow follow : follows) {
        // 4.1.获取粉丝id
        Long userId = follow.getUserId();
        // 4.2.推送
        String key = FEED_KEY + userId;//粉丝id
        stringRedisTemplate.opsForZSet().add(key, blog.getId().toString(), System.currentTimeMillis());
    }
    // 5.返回id
    return Result.ok(blog.getId());
}
五个步骤:
- 从
UserHolder取作者 id 填进blog。 save(blog)落库,失败直接返回。必须落库成功之后才推,否则会出现”粉丝收件箱里有这篇笔记,但点进去查不到”的情况。- 查作者的粉丝:
followService.query().eq("follow_user_id", user.getId()).list(),条件是follow_user_id = 作者,查出来的每一行的user_id才是粉丝。这里一定要用follow_user_id,用user_id就变成”我关注了谁”了。 - 循环给每个粉丝推:
ZADD feed:{粉丝id} {当前时间戳} {笔记id},一个粉丝一个 key,所以是一批ZADD。 - 返回笔记 id。
Controller 相应地改成一行:
@PostMapping
public Result saveBlog(@RequestBody Blog blog) {
    return blogService.saveBlog(blog);
}
7.4 读:为什么传统分页不行
假设收件箱里按时间从新到旧是 10, 9, 8, 7, 6, 5, 4, 3, 2, 1,每页 5 条。
- t1:读第 1 页(
page = 1, size = 5),拿到 10, 9, 8, 7, 6。 - t2:有人发了一篇新笔记 11,插到了列表头部。
- t3:读第 2 页(
page = 2, size = 5),SQL 会按角标 5–9 取,此时列表是 11, 10, 9, 8, 7, 6, 5, 4, 3, 2, 1,角标 5–9 对应 6, 5, 4, 3, 2。
结果 6 被读了两遍,而 1 如果继续往下翻还可能读不到。根因是列表头部的插入让所有元素的角标都往后挪了一位,而传统分页依赖角标。
Feed 流的特点是数据一直在头部新增,所以必须换一种”不依赖角标”的分页方式。
7.5 滚动分页的设计
给出的方案是记住”上次读到哪个时间戳”,而不是”读到第几页”。具体是两个参数:
- lastId:上一次查询结果中的最小时间戳。第一次查询传当前时间戳(相当于 ∞)。
- offset:偏移量。用来跳过上一页中时间戳等于
lastId的那几条记录。
对应到 Redis 命令:
ZREVRANGEBYSCORE feed:{userId} {lastId} 0 WITHSCORES LIMIT {offset} {size}
ZREVRANGEBYSCORE 按 score 从大到小取,也就是从新到旧,正好符合”先看最新的”。max = lastId、min = 0 表示只取时间戳不超过 lastId 的记录。
为什么需要 offset 这个看起来多余的参数。因为 ZREVRANGEBYSCORE 的 max 是闭区间,时间戳正好等于 lastId 的记录会被再次返回。上一页的最后一条必有 score = lastId,所以翻下一页时至少要跳过 1 条。如果上一页末尾有多条记录的时间戳相同,跳过的数量就要更多,因此 offset 得是一个算出来的数,不能固定写 1。
offset 怎么算。上一页返回的记录里,统计”时间戳等于最小时间戳的那一组有几条”,这就是要给下一页的 offset。代码里是在解析返回数据的循环里顺手算出来的。
7.6 queryBlogOfFollow 怎么写
先看完整代码,再拆。
@Override
public Result queryBlogOfFollow(Long max, Integer offset) {
    // 1.获取当前用户
    Long userId = UserHolder.getUser().getId();
    // 2.查询收件箱 ZREVRANGEBYSCORE key Max Min LIMIT offset count
    String key = FEED_KEY + userId;//粉丝自己的id
    Set<ZSetOperations.TypedTuple<String>> typedTuples = stringRedisTemplate.opsForZSet()
            .reverseRangeByScoreWithScores(key, 0, max, offset, 2);
    // 3.非空判断
    if (typedTuples == null || typedTuples.isEmpty()) {
        return Result.ok();
    }
    // 4.解析数据:blogId、minTime(时间戳)、offset
    List<Long> ids = new ArrayList<>(typedTuples.size());
    long minTime = 0;
    int os = 1;
    for (ZSetOperations.TypedTuple<String> tuple : typedTuples) {
        // 4.1.获取id
        ids.add(Long.valueOf(tuple.getValue()));
        // 4.2.获取分数(时间戳)
        long time = tuple.getScore().longValue();
        if(time == minTime){
            os++;
        }else{
            minTime = time;
            os = 1;
        }
    }

    // 5.根据id查询blog
    String idStr = StrUtil.join(",", ids);
    List<Blog> blogs = query().in("id", ids).last("ORDER BY FIELD(id," + idStr + ")").list();

    for (Blog blog : blogs) {
        // 5.1.查询blog有关的用户
        queryBlogUser(blog);
        // 5.2.查询blog是否被点赞
        isBlogLiked(blog);
    }

    // 6.封装并返回
    ScrollResult r = new ScrollResult();
    r.setList(blogs);
    r.setOffset(os);
    r.setMinTime(minTime);

    return Result.ok(r);
}
第 1 步:取当前用户
收件箱是按用户区分的,key 是 feed:{当前登录用户}。这个方法只能看自己的推送,所以用户 id 从 UserHolder 拿,不从参数拿。
第 2 步:查收件箱
reverseRangeByScoreWithScores(key, 0, max, offset, 2) 是 Spring Data Redis 的封装,对应:
ZREVRANGEBYSCORE feed:{userId} {max} 0 WITHSCORES LIMIT {offset} 2
参数顺序是个坑:Redis CLI 里是 max 在前、min 在后,而 Java 方法签名是 (key, min, max, offset, count),把 Redis 的顺序照抄过来就写反了。这里 min 填 0、max 填 lastId。
最后那个 2 是每页条数,课件为了演示方便写死的。实际项目里应该做成参数或常量。
返回值类型 Set<ZSetOperations.TypedTuple<String>> 表示”带 score 的结果集”,每个 TypedTuple 里有 getValue()(member,也就是笔记 id)和 getScore()(时间戳)。因为用了 WithScores,才能拿到时间戳来算 minTime。
第 3 步:非空判断
收件箱没有更多数据时直接 return Result.ok(),data 为 null,前端据此判断”到底了,停止加载”。
第 4 步:解析数据并算 offset
这是整个方法里最需要想明白的一段。循环按时间戳从大到小遍历本页的记录,三个变量的含义:
ids:本页所有笔记 id,顺便收集起来。minTime:本页最小的那个时间戳,也就是下一页的lastId。os:本页里最后一个时间戳分组的条数,也就是下一页要跳过的数量。
循环体做两件事:
- 把
tuple.getValue()转成Long放进ids。 - 把当前记录的
time和minTime比:相等就os++,不等就把minTime更新成当前time并把os重置为 1。
因为是从大到小遍历,minTime 会被一路更新到本页最小的那个值;而每次时间戳变化都会把 os 重置,所以循环结束时 os 恰好等于”本页最小的那个时间戳出现了几次”。初始值 minTime = 0, os = 1 的作用是让第一条记录必然走 else 分支,把 minTime 和 os 初始化成第一条记录的值。
第 5 步:根据 id 查笔记
StrUtil.join(",", ids)把 id 拼成9,8这样的串。query().in("id", ids)生成WHERE id IN (...),MyBatis-Plus 用占位符展开,安全。.last("ORDER BY FIELD(id, 9, 8)")把顺序摆回来。这一步不能省,因为IN查询的返回顺序由数据库决定(通常按主键),而 Feed 必须按时间从新到旧展示。这和点赞排行榜是同一个坑。- 拿到
blogs之后,复用”达人探店”那章写的两个私有方法补作者信息和isLike。
第 6 步:封装 ScrollResult
ScrollResult 是本章新增的 DTO(其实我认为应该叫做 VO,毕竟是后端相应给前端 fe):
@Data
public class ScrollResult {
    private List<?> list;
    private Long minTime;
    private Integer offset;
}
三个字段就是前端翻页需要的全部信息:这一页的内容、下一页的 lastId(minTime)、下一页的 offset。
7.7 前端怎么配合
滚动分页的契约是”把上一次的返回值原样传回来”:
- 第一次请求:
lastId = 当前时间戳,offset = 0。 - 后端返回
{ list, minTime, offset }。 - 下一次请求:
lastId = minTime,offset = 上一次返回的 offset。 - 收到
list为空时停止加载。
因为第一次的 lastId 是当前时间戳,比收件箱里所有 score 都大,所以第一次相当于取最新的那一批。
7.8 手推一遍:造一组数据走两页
假设 A 的收件箱 feed:{A} 里有 5 篇笔记,笔记 id 和时间戳(毫秒)如下,注意 9 和 8 的时间戳相同:
| score(时间戳) | 1000 | 900 | 800 | 800 | 700 |
|---|---|---|---|---|---|
| member(笔记 id) | 11 | 10 | 9 | 8 | 7 |
每页 2 条。
第 1 次请求:lastId = 2000(当前时间),offset = 0
ZREVRANGEBYSCORE feed:A 2000 0 WITHSCORES LIMIT 0 2
# 返回 11(1000)、10(900)
解析循环:
| 轮次 | time | 与 minTime 比较 | minTime | os |
|---|---|---|---|---|
| 初始 | — | — | 0 | 1 |
| 11 | 1000 | 不等,重置 | 1000 | 1 |
| 10 | 900 | 不等,重置 | 900 | 1 |
返回 { list: [11, 10], minTime: 900, offset: 1 }。
第 2 次请求:lastId = 900,offset = 1
ZREVRANGEBYSCORE feed:A 900 0 WITHSCORES LIMIT 1 2
# 时间戳 ≤ 900 的有 10、9、8、7;跳过 1 条(也就是 10),取 9(800)、8(800)
解析循环:
| 轮次 | time | 与 minTime 比较 | minTime | os |
|---|---|---|---|---|
| 初始 | — | — | 0 | 1 |
| 9 | 800 | 不等,重置 | 800 | 1 |
| 8 | 800 | 相等,累加 | 800 | 2 |
返回 { list: [9, 8], minTime: 800, offset: 2 }。注意这里 offset 变成 2 了,因为时间戳 800 有两条记录。
第 3 次请求:lastId = 800,offset = 2
ZREVRANGEBYSCORE feed:A 800 0 WITHSCORES LIMIT 2 2
# 时间戳 ≤ 800 的有 9、8、7;跳过 2 条(9 和 8),返回 7(700)
返回 { list: [7], minTime: 700, offset: 1 }。
第 4 次请求:lastId = 700,offset = 1 → 没有更多数据,返回空,前端停止加载。
看两件事:
- 9 和 8 没有重复出现。因为它们和上一页的边界值
lastId相等(都是 800),如果不加 offset 就会被重复读到,os = 2正好跳过它们。 - 新笔记插进来不影响翻页。如果这时有人推了一篇时间戳 1500 的笔记,因为它大于
lastId,后面的请求根本不会带上它,也就不存在”角标漂移”的问题。这正是滚动分页相对传统分页的优势。
关于同一时间戳内部的顺序:ZSet 中 score 相同的 member 会按 member 的字典序排列,所以 LIMIT 跳过的是”条数”而不是”特定几条”。只要这一组里有几条就跳过几条,顺序不影响结果。